MLA
通过潜在表示压缩键值缓存,降低长上下文推理的显存与带宽压力。
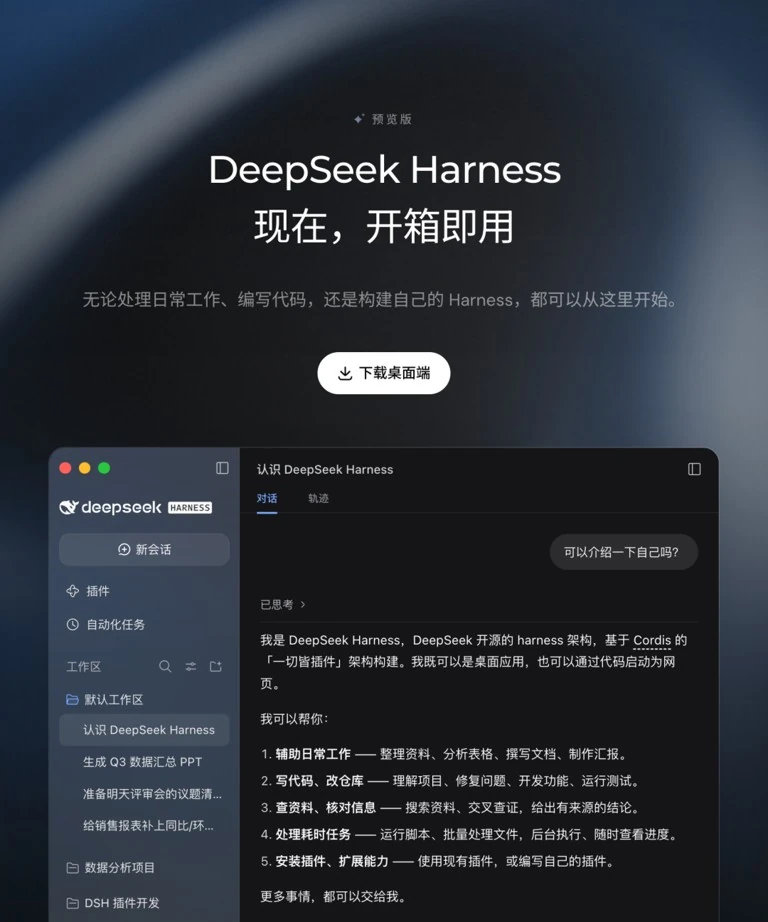
在 DeepSeek网页版 发起任务,经 API 开放平台连接业务,再由 Harness 固定测试集、版本和指标。桥面承载正文,桥头堡给出入口,所有关键路径都能直接抵达。
从注意力结构、训练方式、专家路由到长上下文,构成复杂任务的承重体系。
通过潜在表示压缩键值缓存,降低长上下文推理的显存与带宽压力。
在可验证任务中学习推理、复核和纠错路径,而不止生成单步答案。
按 Token 路由到不同专家,让模型容量与单次推断开销分离规划。
承载长文档、仓库级代码和连续会话,保留更完整的任务线索。
每个场景先定义输入、边界与验收条件,再开始推理。
分析依赖、拆分模块、定位风险并补齐测试。
拆解命题和引理,逐步验证必要条件。
从长篇材料提取义务、冲突与交易边界。
将假设转成指标、约束、代码和偏差记录。
规划工具调用,保存状态并处理失败重试。
按显存、吞吐和隐私要求选择运行方案。
在服务端安全保存访问凭据,不写入浏览器源码。
依据难度、上下文、延迟和预算规划调用。
保存版本、测试集和指标,使结果可复现。
临时对话走网页端,系统集成走 API,质量验收走 Harness。
$ harness run \
  --suite reasoning-cn \
  --metrics accuracy,latency,cost

[span 01] input locked
[span 42] revision found
[span 60] report sealed

PASS accuracy: 0.998保存数据、提示、采样参数与模型标识,避免结果漂移后无法解释。
将准确率、人工复核、时延和 Token 成本放入同一份记录。
不需要。本地页面可直接打开演示工作区;正式上线后按实际服务地址配置入口。
先确认数据边界、鉴权、超时、重试、日志脱敏与预算。
适合有固定输入与验收标准的代码、数学、抽取、Agent 和长文档任务。
复杂推理关注正确率;通用高频任务关注吞吐;离线场景按设备资源选择尺寸。